# DeepSeek-V3.2
# DeepSeek Sparse Attention
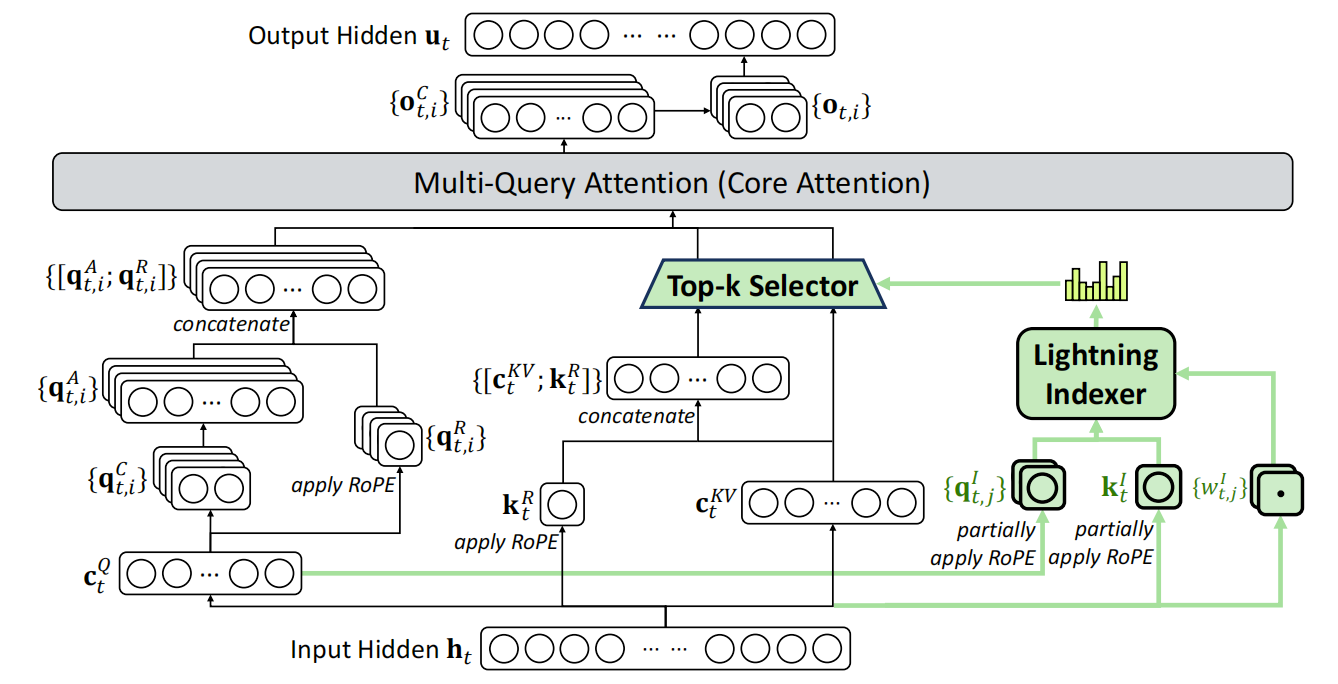
DSA 在 MLA 的基础上引入闪电索引器(Lightning Indexer),先为可见 token 打分并选取 top-k 个位置,再由主注意力在这些位置上计算注意力权重并聚合信息。
# Lightning Indexer
对于当前 token 的隐藏表示 ,索引器生成 个 Query 向量及对应的头权重;每个候选 token 则生成一个由所有索引头共享的 Key:
DeepSeek-V3.2 中,,索引头数 ,每头维度 。索引器为每个可见位置 计算:
即:各头先计算 Query 与 Key 的内积,经 ReLU 后按头权重求和,得到该位置的一个总分。头权重由当前 token 动态生成,索引分数用于排序,不是概率。
# Top-k 选择
索引器从可见位置中选出分数最高的至多 个位置:
DeepSeek-V3.2 使用 。主注意力随后读取这些位置对应的 MLA 键值条目 ,计算输出:
索引分数决定选哪些位置,主注意力重新计算这些位置的权重。 同一查询的所有主注意力头共享所选位置集合,但各头的注意力权重可以不同。
# 两阶段训练
首先进行稠密预热:保留完整注意力,冻结主模型,只训练索引器。将各主注意力头的注意力权重求和并归一化,得到目标分布 ,用 KL 散度训练索引器:
随后进行稀疏训练:启用 top-k 选择,主模型通过语言建模损失适应稀疏注意力;索引器继续通过 KL 散度学习,但仅在选中位置内对齐:
# DeepSeek-V3.2 RL
GRPO 对同一问题采样一组回答,根据回答奖励相对于组内平均奖励的高低来更新模型。本文采用的优势为:
同一回答中的所有 token 共享该回答的优势。优势为正时鼓励该回答,优势为负时抑制该回答。
# 无偏 KL 估计
KL 惩罚限制当前策略偏离参考策略过远。相比原先使用的 K3 估计形式,V3.2 增加了重要性采样修正,纠正 “数据来自旧策略,而目标涉及当前策略” 的分布差异。
省略相同的上下文条件,定义:
原来的 K3 形式及修正后的估计分别为:
在相应的采样与支持集条件下,修正后的估计在旧策略采样的期望下对应当前策略相对于参考策略的 KL 散度。它用于减少估计偏差、改善训练稳定性。不同领域可以使用不同的 KL 惩罚强度,数学任务中也可以减弱或省略该惩罚。
# Off-policy 与序列掩码
**Off-policy(离策略)** 指训练数据的采样策略与当前被优化的策略不一致。例如,模型 A 生成一批回答,更新为模型 B 后,仍继续使用 A 生成的数据训练。多次参数更新以及训练、推理框架的差异都会加剧这种不一致。
V3.2 对 “优势为负且策略偏离过大” 的回答,屏蔽其策略优化项。定义序列平均对数概率比:
对应掩码为:
是基于采样序列的偏离指标。该机制避免过时的负优势样本继续产生不稳定更新;掩码作用于策略优化项,不同时屏蔽 KL 惩罚项。
# Keep Routing
MoE 模型为每个 token 选择部分专家参与计算。采样与训练时的专家选择可能因框架差异或参数更新而发生变化,导致优化不稳定。
Keep Routing 的具体操作是:
- 采样时:记录每个 token 在各 MoE 层选中的专家编号。
- 训练时:对对应位置强制使用记录的专家选择。
- 更新时:梯度通过这些专家路径传播,更新相关参数。
采样阶段指模型用当前策略生成回答集合的过程。
# Top-k、Top-p 与 Keep Sampling Mask
Top-k 和 Top-p 都在生成下一个 token 时,先筛选词表候选,再将保留的概率重新归一化并随机采样。
- Top-k:保留概率最高的固定 个 token。
- Top-p(核采样):按概率从高到低排列,保留累计概率达到阈值 的最小候选集合。
| 方法 | 优点 | 局限 |
|---|---|---|
| Top-k | 简单直观,候选数量固定,便于控制采样范围 | 不适应分布形状:分布集中时可能保留低质量尾部,分布平坦时可能排除合理候选 |
| Top-p | 随分布自动调整候选数量,分布集中时收缩、分散时扩大 | 候选数量不固定;分布平坦时可能保留大量 token,阈值过小也可能损失多样性 |
两者都依赖参数选择,不能保证事实正确性。这里的 Top-k 筛选的是下一个 token 的词表候选。Keep Sampling Mask 保存采样时的候选集合,并在训练时对当前策略使用相同集合、重新归一化概率:
其中, 是当前上下文, 是采样时保存的候选集合。这样可以让采样策略与当前策略在对应位置使用相同的动作空间,减少截断采样带来的重要性采样不一致。
# Tool Use
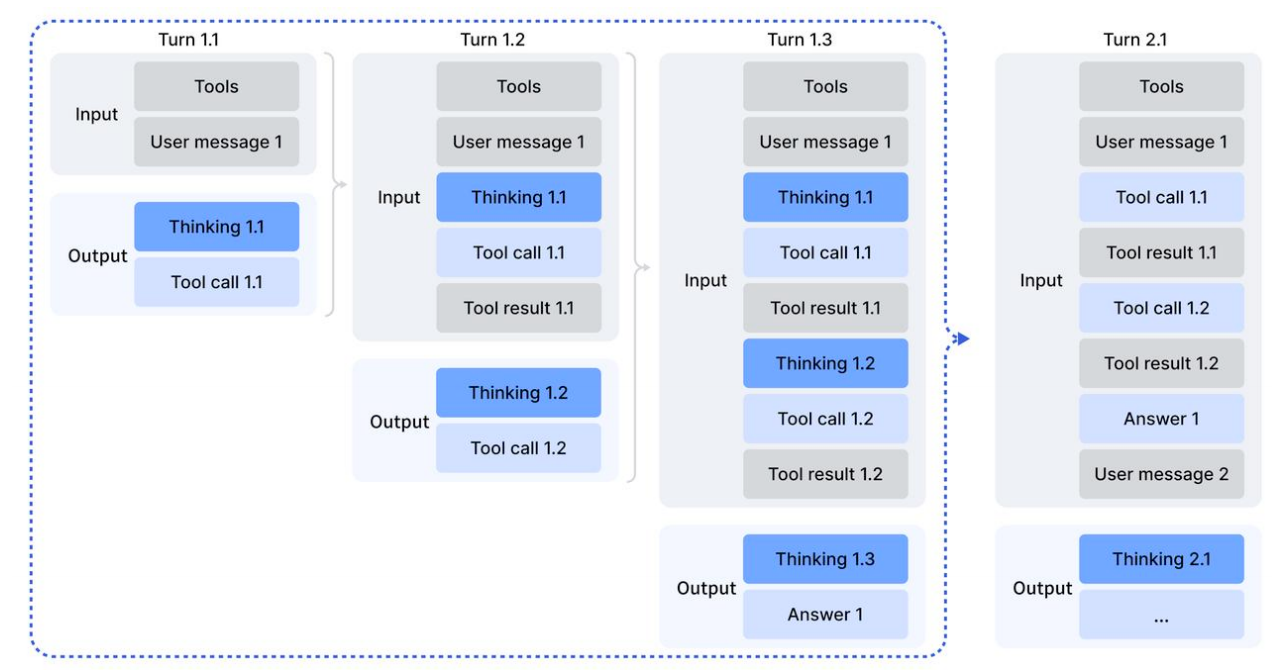
DeepSeek-V3.2 将思考能力融入工具调用场景,使模型能够在推理过程中调用工具,并结合工具返回的信息继续推理。
# 思考上下文管理
工具调用任务通常需要多轮交互:模型先分析问题,调用工具获取信息,再根据结果继续分析。如果每次收到工具结果都删除已有推理内容,模型就需要反复推导先前的结论,造成 token 浪费。
为此,DeepSeek-V3.2 根据新增消息的类型管理历史推理内容:
| 新增消息类型 | 历史推理内容 | 历史工具调用及其结果 |
|---|---|---|
| Tool Call, Tool Result | 保留 | 保留 |
| User Message | 删除 | 保留 |
因此,在处理同一用户请求的连续工具调用过程中,模型能够保留此前的推理,接着工具结果继续思考。当用户提出新的请求时,则清除历史推理内容,同时保留工具调用及其结果。
这一机制依赖消息角色的正确区分。某些 Agent 框架通过用户消息模拟工具结果,会触发历史推理内容的删除,无法充分利用推理保留机制。论文因此建议在此类框架中使用非思考模型。
# 冷启动
冷启动的目标是让模型初步具备 “在思考过程中调用工具” 的能力,为后续强化学习提供可用的交互轨迹。
已有数据分别支持两类能力:
- 推理能力:模型先进行推理,再给出最终答案,推理内容使用
<think></think>标签标记,但不涉及智能体工具交互。 - 工具使用能力:模型根据系统提示词调用工具,但数据中不包含显式推理过程。
DeepSeek-V3.2 通过精心设计系统提示词,引导模型将这两类能力结合起来:在推理过程中按需调用工具,读取工具结果,再继续推理,直至给出最终答案。不同任务使用相应的系统提示词。
## Tools
You have access to the following tools:
{TOOL-DESCRIPTIONS}
Important: ALWAYS adhere to this exact format for tool use:
{TOOLCALL-FORMAT}
这一阶段并不要求模型已经能够稳定完成所有任务。即使结合思考与工具调用的行为还不够稳健,只要模型能够生成部分符合预期的轨迹,就能为后续强化学习提供起点,逐步增强该能力。
