# DeepSeek-R1-Zero
使用思维链提示词,或是在后训练阶段学习高质量多步推理轨迹的方式约束模型去模仿人类的思维过程,其性能从根本上受到人类所提供示例的限制,阻碍了模型探索更优的、不同于人类思维方式的推理路径。
核心假设:人类定义的推理模式可能会限制模型的探索。
# PPO-GRPO

# PPO
Proximal Policy Optimization,近端策略优化通过限制策略更新幅度,提高强化学习训练的稳定性。在大语言模型中,可以将生成每个 token 看作一次动作:状态 st=(q,o<t) 是问题与已生成的前缀,动作 at=ot 是当前生成的 token。
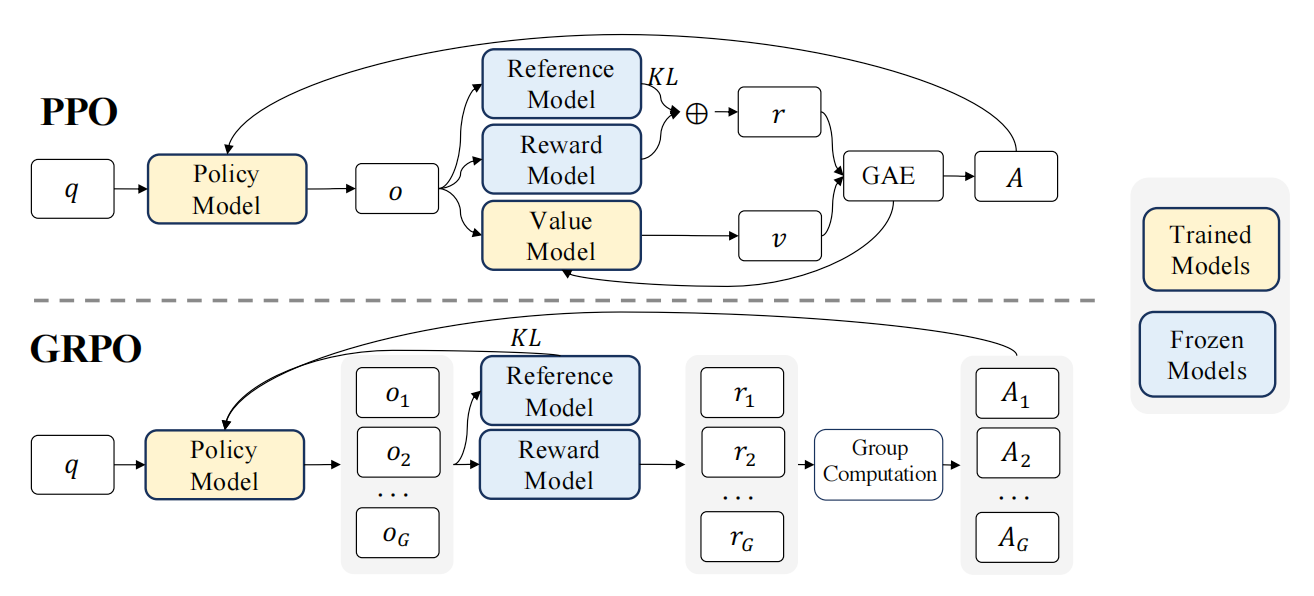
PPO 通常采用 Actor–Critic 框架:策略模型 πθ 负责生成回答,价值模型 Vϕ(st) 预测从当前状态出发的期望累积奖励,为优势估计提供基线。
# 训练目标
定义新旧策略对同一个 token 的概率比:
ρt(θ)=πold(at∣st)πθ(at∣st).
忽略可选的熵正则,PPO 的总损失可以写为:
LPPO=−Et[min(ρtA^t,clip(ρt,1−ϵ,1+ϵ)A^t)]+2cVEt[(Vϕ(st)−U^t)2].
其中:
- πθ:正在更新的策略模型。
- πold:生成本轮训练数据的旧策略,更新期间固定。
- A^t:优势估计,衡量当前动作相对于状态基线的好坏。
- ϵ:裁剪范围参数,用于抑制过大的策略更新。
- U^t:价值模型的回归目标。
- cV:价值损失权重。
- Et:对采样批次中的有效 token 位置取平均。
第一项更新策略模型,鼓励具有正优势的动作;第二项训练价值模型,使其能够更准确地预测未来回报。
在论文中讨论的 LLM PPO 实现中,参考策略 KL 惩罚被加入每个 token 的奖励:
rt=1[t=T]R(q,o)−βlogπref(at∣st)πold(at∣st).
其中,R(q,o) 是整条回答的任务奖励,T 是回答长度,πref 是参考策略,β 控制 KL 惩罚强度。任务奖励在回答结束时给出,KL 惩罚则逐 token 计算,并通过优势估计影响策略更新。
# GAE
PPO 通常使用 GAE,即 Generalized Advantage Estimation,广义优势估计计算优势。首先,保存更新前的价值预测 vt=Vϕold(st),计算 TD Error(时序差分误差):
δt=rt+γvt+1−vt.
它比较 “本步奖励加下一状态的折扣价值” 与 “当前状态的价值预测”。δt>0 表示本步结果比原先预期更好,γ 是奖励折扣系数。
随后,从回答末尾向前递推:
A^tGAE=δt+γλA^t+1GAE=l=0∑T−t(γλ)lδt+l.
对于真正终止的回答,设 vT+1=0、A^T+1=0。其中,λ 控制未来 TD 误差的权重,用于调节估计的偏差与方差:
- λ=0:只使用一步 TD 误差,更依赖价值模型的预测。
- λ=1:在完整终止轨迹上,优势等于实际折扣回报减去当前价值基线。
一种常见的价值回归目标为:
U^t=A^tGAE+vt.
策略更新时,优势作为固定量;价值更新时,U^t 作为固定监督目标。因此,即使任务奖励仅在回答末尾出现,GAE 也能将奖励信号向前传播到各 token 位置。
# GRPO
GRPO 保留了 PPO 的裁剪策略目标,但通过同一问题下多条回答的奖励进行相对比较,替代价值模型与 GAE,从而省去价值模型的训练开销。
# 组相对优势
对于问题 q,从旧策略中采样 G 条回答 {o1,…,oG},获得对应奖励 {R1,…,RG}。结果奖励型 GRPO 的优势为:
A^i=std({R1,…,RG})+ηRi−mean({R1,…,RG}).
其中,η 是防止除零的数值稳定项。高于组内平均奖励的回答具有正优势,低于平均奖励的回答具有负优势。同一条回答中的所有 token 共用优势 A^i。
# 训练目标
定义第 i 条回答中第 t 个 token 的概率比:
ρi,t(θ)=πold(ai,t∣si,t)πθ(ai,t∣si,t).
GRPO 的 token 级损失为:
LGRPO=Eq[G1i=1∑GTi1t=1∑Ti(−min(ρi,tA^i,clip(ρi,t,1−ϵ,1+ϵ)A^i)+βki,t)].
其中,Ti 是第 i 条回答的长度,ki,t 是论文使用的采样 KL 正则项:
ki,t=πθ(ai,t∣si,t)πref(ai,t∣si,t)−logπθ(ai,t∣si,t)πref(ai,t∣si,t)−1.
该表达式在动作采自当前策略时,其期望等于对应的 KL 散度。与上述 PPO 实现不同,GRPO 将 KL 正则直接加入策略损失,而不将其纳入组相对优势计算。
# 联系和区别
| 对比项 | PPO | GRPO |
|---|
| 优势计算 | 通常使用 TD Error 与 GAE 通过价值模型预测 | 对组内平均奖励进行标准化 |
| 价值模型及其损失 | 需要 | 不需要 |
| 同一回答内不同 token 优势 | 通常随位置 t 变化 | 使用相同的总回答级优势 |
| 参考策略 KL | 加入 token 奖励,间接影响策略损失 | 直接加入策略损失 |
| 主要额外开销 | 价值模型训练与相关超参数调优 | 每个问题需要采样多条回答 |
在长思维链训练中,后续反思和修正可能改变回答的最终结果,使价值模型难以根据部分前缀准确预测回报。GRPO 通过组内奖励比较绕过这一预测问题,更适合资源受限的大模型训练,但其学习信号也依赖组内回答的奖励差异。
# Reward Model

DeepSeek-R1-Zero 不使用神经网络奖励模型,而是采用基于规则的奖励:R=Racc+Rformat,两项权重相同。其中,准确性奖励通过数学答案核验、代码测试用例等判断回答是否正确;格式奖励鼓励模型将推理过程放在 <think>...</think> 标签内,再给出最终答案。该设计不直接监督具体推理步骤,并减少神经奖励模型带来的计算开销及 **Reward Hacking(奖励投机)** 风险,即模型利用评分机制的漏洞获得高分,却没有真正完成任务;不过,规则奖励也无法完全避免这一问题。
在强化学习过程中,模型逐渐自发产生更长的推理、反思和替代解法探索,并出现 “顿悟时刻(aha moment)”:反思中 “wait” 等表达的使用频率突然增加,体现出推理行为的变化,而非人为显式教授的固定策略。
# DeepSeek-R1
DeepSeek-R1 在强化推理能力的同时,通过冷启动数据、监督微调和偏好对齐,改善 DeepSeek-R1-Zero 的可读性与语言混用问题,并提升写作、通用问答等能力。
# 训练流程

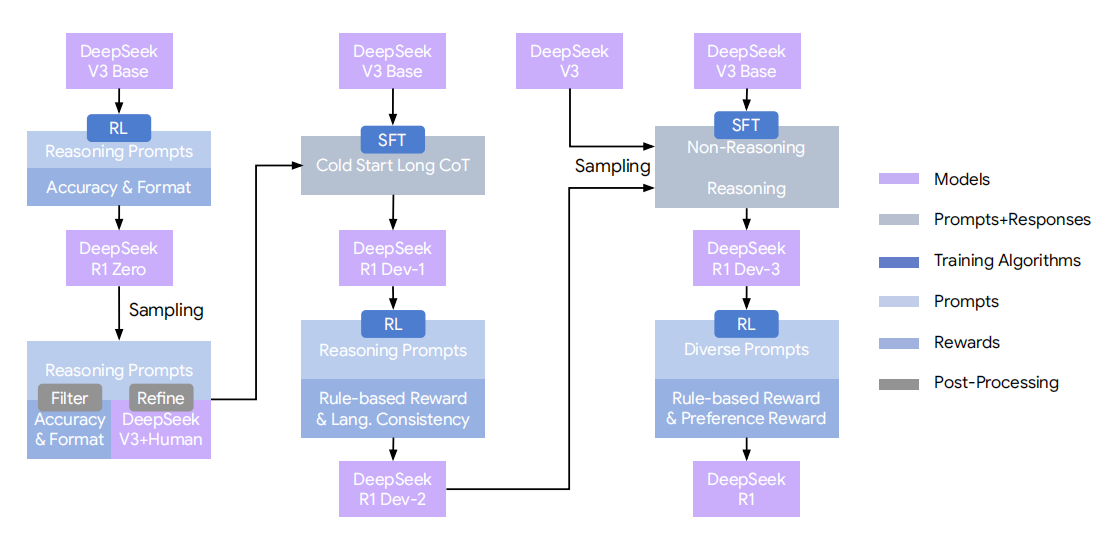
整体流程为:冷启动 SFT → 第一阶段 RL → 拒绝采样与 SFT → 第二阶段 RL。
- 冷启动 SFT:收集数千条具有对话式、符合人类偏好的思考过程的数据,对基础模型进行监督微调,为后续训练提供更清晰、易读的输出基础。
- 第一阶段 RL:通过强化学习提升推理性能,并引入语言一致性奖励,缓解思维链中的语言混用。
- 拒绝采样与 SFT:生成并筛选高质量回答,再结合推理类与非推理类数据进行监督微调,使模型兼顾推理能力和写作等通用能力。
- 第二阶段 RL:结合规则奖励与模型奖励,继续优化推理能力,并进一步对齐人类对有用性和无害性的偏好。
# Reward
DeepSeek-R1 根据样本类型选择奖励,再叠加语言一致性奖励。对于单个样本,可以整理为:
R(q,o)={Racc+Rformat+Rlanguage,RRM+Rformat+Rlanguage,推理类样本,通用类样本.
其中:
- Racc:准确性奖励,通过数学答案核验、代码测试等规则评估正确性。
- Rformat:格式奖励,鼓励使用规定的推理与答案结构。
- RRM:奖励模型给出的分数,根据样本所属类别,采用有用性奖励或安全性奖励。
- Rlanguage:语言一致性奖励,衡量思维链中目标语言词语的比例。
Rlanguage=思维链中的总词数思维链中目标语言的词数.
其中,语言一致性奖励适用于推理类和非推理类数据;它可能略微牺牲任务性能,但能够改善可读性。
# 有用性与安全性奖励
对于难以通过确定性规则评分的通用任务,DeepSeek-R1 使用神经网络奖励模型捕捉人类偏好。
| 奖励模型 | 评估范围 | 训练方式与数据 |
|---|
| 有用性奖励模型 | 仅评估最终总结或答案,关注实用性与相关性,尽量不干扰推理过程 | 使用约 6.6 万个偏好对,通过成对比较训练 |
| 安全性奖励模型 | 评估完整回答,包括推理过程和最终答案 | 使用约 10.6 万条提示及其带安全标签的回答,采用逐样本训练 |
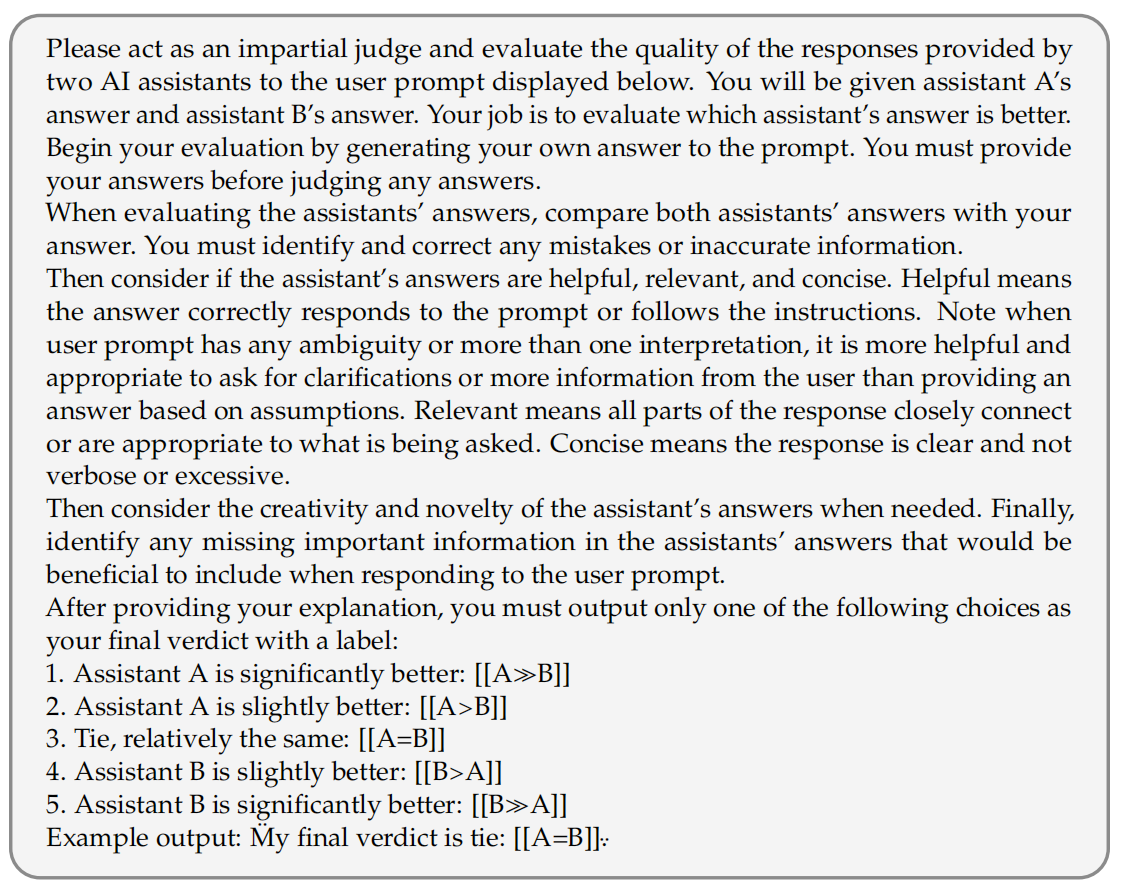
有用性偏好数据由 DeepSeek-V3 辅助评判:对每个回答对独立评判四次,随机交换位置并取平均,仅保留评分差异大于 1 的样本,同时控制数据集整体的回答长度差异,以减轻位置和长度偏差。奖励模型在与 DeepSeek-R1 一致的模型架构上增加奖励头,输出标量分数。