# DeepSeek-V3

# Multi-Head Latent Attention
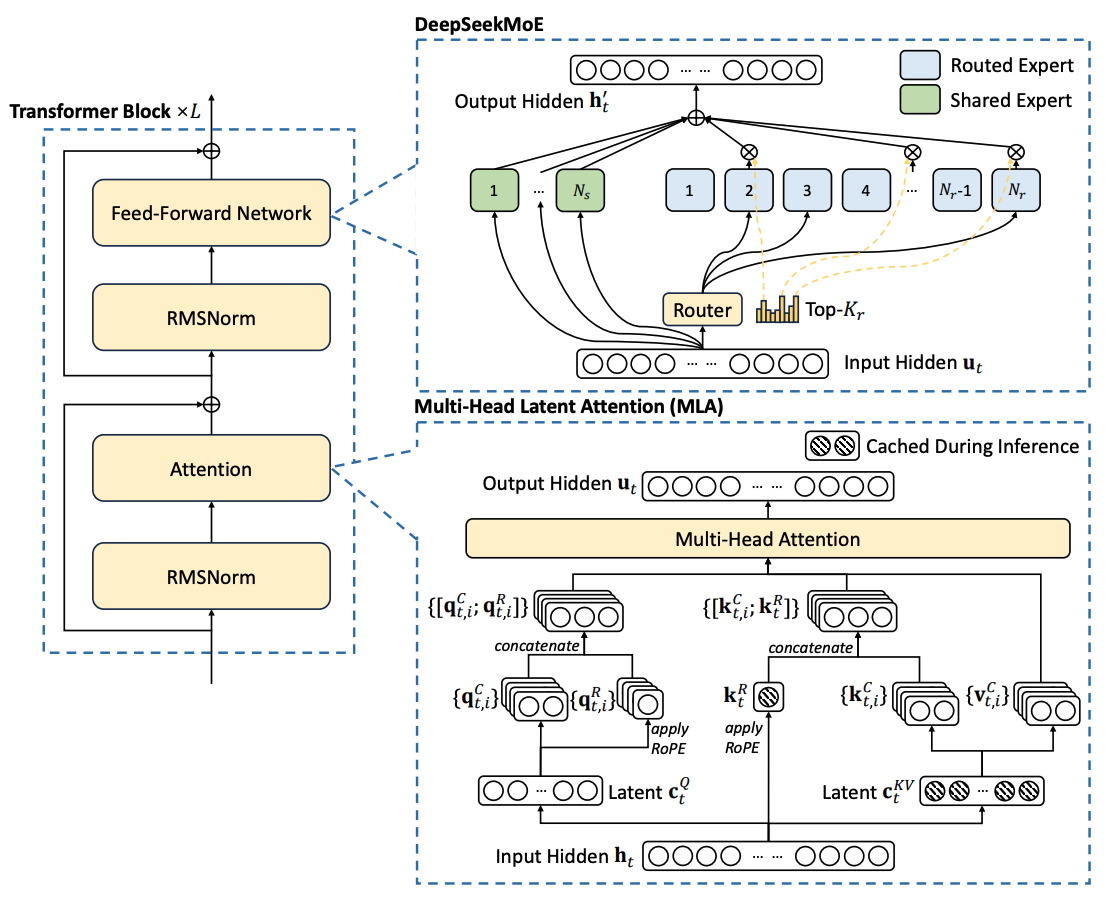
MLA 的核心是:将所有注意力头的 Key 和 Value 联合压缩为一个共享的低维潜在向量,并将用于 RoPE 的位置分量单独处理,从而减少推理时的 KV Cache。 各个头通过不同的投影矩阵使用这份共享表示。
以下以单层、单个 Token 为例,采用列向量表示:
| 符号 | 含义 | 维度 |
|---|
| ht | 第 t 个 Token 的输入隐藏表示 | d |
| nh | 注意力头数 | 标量 |
| dh | 每个头的内容 Key、Query 和 Value 维度 | 标量 |
| dhR | 每个头的 RoPE 分量维度 | 标量 |
其中,dc,dc′≪nhdh。上标 C 表示内容分量,R 表示应用 RoPE 的位置分量。
# KeyValue
首先,将输入压缩为一个共享的 KV 潜在向量:
ctKV=WDKVht,WDKV∈Rdc×d,ctKV∈Rdc.
对于第 i 个头,分别通过上投影获得内容 Key 和 Value:
kt,iC=WiUKctKV,vt,iC=WiUVctKV,
WiUK,WiUV∈Rdh×dc,kt,iC,vt,iC∈Rdh.
这里的 WiUK 和 WiUV 是完整上投影矩阵中对应第 i 个头的行块。所有头读取同一个 ctKV,但通过不同投影得到各自的 Key 和 Value。
与此同时,直接从原始输入生成独立的位置 Key:
ktR=RoPEt(WKRht),WKR∈RdhR×d,ktR∈RdhR.
RoPEt 表示应用位置 t 对应的旋转变换。这个位置 Key 在所有头之间共享。第 i 个头的完整 Key 为:
kt,i=[kt,iC;ktR]∈Rdh+dhR.
因此,每个历史 Token 在每层只需要缓存:
(ctKV,ktR),缓存元素数=dc+dhR.
不需要持久缓存每个头展开后的 kt,iC 和 vt,iC。
# Query
Query 首先经过另一套下投影:
ctQ=WDQht,WDQ∈Rdc′×d,ctQ∈Rdc′.
随后,第 i 个头从该潜在向量生成内容 Query 和位置 Query:
qt,iC=WiUQctQ,WiUQ∈Rdh×dc′,qt,iC∈Rdh,
qt,iR=RoPEt(WiQRctQ),WiQR∈RdhR×dc′,qt,iR∈RdhR.
拼接后得到:
qt,i=[qt,iC;qt,iR]∈Rdh+dhR.
注意:位置 Query 是各头不同的,位置 Key 则是各头共享的。 Query 的低秩压缩主要用于减少训练时的激活内存;自回归推理通常不需要保存历史 Query。
# 注意力计算
当前位置 t 的 Query 与历史位置 j 的 Key 进行匹配。由于内容与位置采用拼接形式,点积可以拆成两项:
st,j,i=dh+dhR(qt,iC)⊤kj,iC+(qt,iR)⊤kjR.
第一项计算内容匹配,第二项通过 RoPE 引入相对位置信息。对所有可见位置统一归一化后,加权聚合 Value:
at,j,i=∑ℓ=1texp(st,ℓ,i)exp(st,j,i),ot,i=j=1∑tat,j,ivj,iC∈Rdh.
最后拼接各头输出,投影回模型隐藏维度:
ut=WO[ot,1;…;ot,nh]∈Rd,WO∈Rd×nhdh.
# 潜在向量的作用
在于内容分量不施加 RoPE,可以利用矩阵乘法的结合律,将 Key 上投影转移到当前 Query 一侧:
(qt,iC)⊤kj,iC=(qt,iC)⊤WiUKcjKV=((WiUK)⊤qt,iC)⊤cjKV.
令:
qt,i=(WiUK)⊤qt,iC∈Rdc.
这样,当前 Query 经过一次变换,就能直接与缓存的 cjKV 计算内容分数,无须逐个展开历史 Key。
Value 同样可以先在潜在空间聚合,再上投影:
ot,i=WiUV(j=1∑tat,j,icjKV).
例如,处理历史 Token 时,每个头都使用同一组 KV 潜在向量,但各头的 Query 和注意力权重不同,因此得到的聚合结果也不同。
# RoPE 数据流
Key 的 RoPE 在一条绕过 KV Latent 的并行分支上。。两者的数据流分别是:
- Query 位置分支:ht→ctQ→WiQRctQ→RoPEt。
- Key 位置分支:ht→WKRht→RoPEt。
- KV 内容分支:ht→ctKV→ 各头的内容 Key 和 Value。
如果对上投影后的内容 Query 和 Key 直接施加 RoPE,令 Rt 表示位置 t 的旋转矩阵,则其点积中会出现:
(qt,iC)⊤Rt⊤RjWiUKcjKV.
中间的 Rt⊤Rj 随历史位置 j 改变,因而无法像前面那样,把 WiUK 简单转移成一个对所有历史位置通用的 Query 变换。将 RoPE 放到独立的小维度位置分支后,内容部分仍然能够直接在 KV 潜在空间计算,位置部分则通过单独缓存的 kjR 计算。
# DeepSeekMoE
DeepSeekMoE 用多个专家 FFN 替代单个稠密 FFN,并将专家分成两类:共享专家处理每个 Token,学习通用知识;路由专家根据 Token 的内容选择性激活,学习不同的专业模式。其细粒度设计将专家划分得更小,在控制激活计算量的同时,提供更灵活的专家组合。
设当前 Token 的输入为 ut∈Rd,共有 Ns 个共享专家、Nr 个路由专家,每个 Token 激活 Kr 个路由专家。每个专家均将 d 维输入映射为 d 维输出,包含残差连接的结果为:
ht′=ut+i=1∑NsFFNi(s)(ut)+i=1∑Nrgi,tFFNi(r)(ut)∈Rd.
其中,gi,t 是路由专家的门控权重,未选中的专家权重为 0,实际不需要计算其输出。
# 可学习中心向量
每个路由专家都有一个可学习中心向量 ei∈Rd,通过与输入做点积计算匹配程度。DeepSeek-V2 在所有路由专家之间应用 Softmax:
si,t=∑j=1Nrexp(ut⊤ej)exp(ut⊤ei).
DeepSeek-V3 则对每个专家独立应用 Sigmoid:
si,t=Sigmoid(ut⊤ei).
设选中的专家索引集合为 It,V3 对这些专家的原始亲和度归一化,得到门控权重:
gi,t=⎩⎪⎨⎪⎧∑j∈Itsj,tsi,t,0,i∈It,i∈/It.
训练时,预测损失通过端到端反向传播,更新 ei,让路由器逐渐学会 Token 与专家的匹配关系。Top-K 的离散选择本身通常不可导,但选中专家的门控权重可导。
# 无辅助损失的负载均衡
路由坍塌是指路由器长期将大多数 Token 分配给少数专家,其他专家几乎得不到训练,进一步强化这种集中现象。辅助损失是在预测损失之外加入的额外训练目标,例如用负载均衡损失鼓励专家被均衡使用。它通过反向传播影响路由器。
DeepSeek-V3 主要通过动态路由偏置控制负载:为每个路由专家设置偏置 bi,使用修正分数选择专家:
It=i∈{1,…,Nr}TopKIndices(si,t+bi, Kr).
这里 TopKIndices 返回分数最高的 Kr 个专家索引。偏置只影响 “选谁”,门控权重仍由原始分数 si,t 归一化得到。 每个训练步骤结束后,根据整个批次的专家负载更新偏置:
- 专家负载过高:bi←bi−γ,降低后续被选中的机会。
- 专家负载过低:bi←bi+γ,增加后续被选中的机会。
其中,γ 是偏置更新速度。
# 序列级均衡约束
为了避免单个序列内部出现极端不均衡,V3 仍保留一个权重极小的辅助损失:
LBal=αi=1∑NrfiPi.
其中,fi 是按原始亲和度 Top-K 统计并缩放的专家选择频率;Pi 是将原始亲和度在所有路由专家间归一化后,该专家在序列中的平均分数。系数 α 被设为极小值,使这一约束主要用于抑制序列内的极端不均衡。
为控制跨节点通信,每个 Token 最多被发送到 M 个计算节点。系统对每个节点上最高的 Kr/M 个专家亲和度求和,据此选择节点,再在节点约束下选择路由专家,从而促进计算与通信重叠。得益于训练阶段的负载均衡,以及推理阶段的专门部署策略,DeepSeek-V3 在训练和推理中均不丢弃 Token。
# Multi-Token Prediction
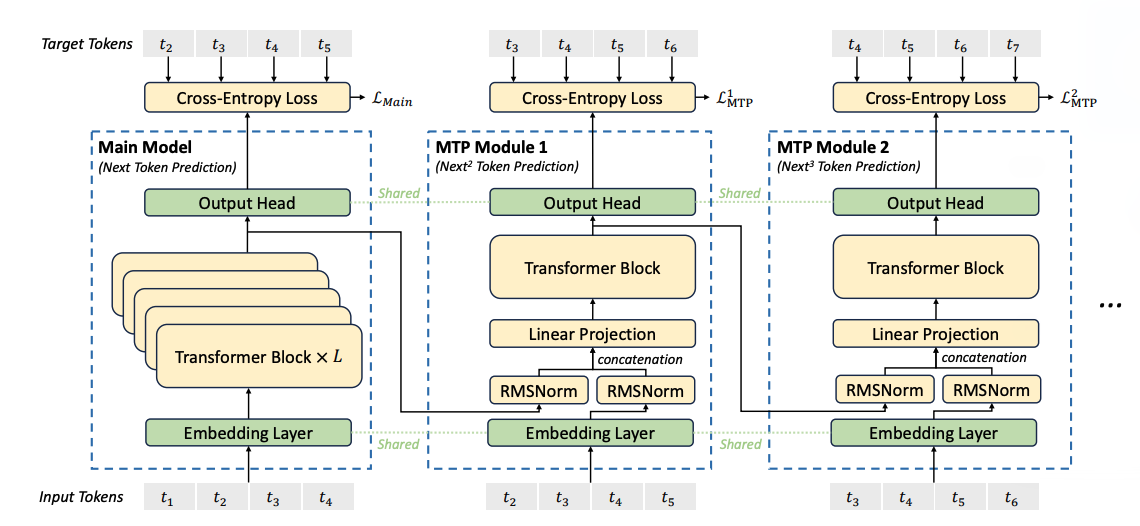
传统语言模型在每个位置预测下一个 Token;DeepSeek-V3 的多 Token 预测(Multi-Token Prediction,MTP)则增加额外的预测目标,使当前位置的表示也参与多个未来 Token 的预测。这样可以提供更密集的训练信号,并促使主模型学习有助于后续预测的表示。
DeepSeek-V3 使用 D 个串联的 MTP 模块,额外预测 D 个 Token。预测深度 k 表示沿 MTP 模块额外向未来预测了几步。

# MTP 模块
第 k 个模块包含与主模型共享的嵌入层和输出头,以及自身的投影矩阵 Mk 和 Transformer 块 TRMk。
首先,将上一深度的表示和补充 Token 的嵌入分别归一化、拼接,再投影:
hi′k=Mk[RMSNorm(hik−1);RMSNorm(Emb(ti+k))].
其中:
- hik−1∈Rd,Emb(ti+k)∈Rd。
- 拼接后为 2d 维,Mk∈Rd×2d。
- 投影后 hi′k∈Rd。
随后,对当前深度的有效位置进行带因果掩码的 Transformer 计算:
h1:T−kk=TRMk(h1:T−k′k).
最后,通过共享输出头,将 d 维表示映射为词表 logits,再经过 Softmax 得到预测分布。其中,T 是输入序列长度。
# 训练目标
每个预测深度都使用真实未来 Token 计算交叉熵。按照原文的归一化方式:
LMTPk=−T1i=k+2∑T+1logPik[ti].
这里,Pik[ti] 是第 k 个 MTP 模块赋予真实 Token ti 的概率;tT+1 是输入序列之后的下一 Token 标签。
对 D 个深度的损失取平均,并乘以权重 λ:
LMTP=Dλk=1∑DLMTPk.
该损失作为主模型下一 Token 预测损失之外的附加目标。由于 MTP 使用主模型的隐藏表示,梯度可以传回主模型,使其表示同时接受多个未来预测任务的监督,而不只是训练额外的输出模块。
# 推理
MTP 主要用于改善训练,推理时可以直接移除 MTP 模块,主模型仍按普通自回归方式生成。也可以保留 MTP 模块用于推测解码:根据已有或生成的 Token 提出后续候选,再由主模型验证,从而降低生成延迟。
# Pretraining
# 数据构建
DeepSeek-V3 的预训练语料包含 14.8T(14.8 万亿)个 Token。相较于 DeepSeek-V2,它提高了数学和编程样本的比例,将多语言覆盖范围扩展到中英文之外,并改进数据处理流程,在减少冗余的同时保持多样性。
训练采用文档打包(Document Packing),将多个文档组织到训练序列中,提高序列空间的利用率,同时保持文档完整性。训练不使用跨样本注意力掩码,但仍使用因果掩码。 如将两个文档按顺序打包后,后者中的 Token 可以关注前面的文档;若使用跨样本掩码,则 两者之间的注意力也会被屏蔽。
# FIM 策略
FIM(Fill-in-Middle,中间填充)通过调整训练文本顺序,让模型学习根据前缀和后缀补全中间内容,适用于代码补全、文本插入等任务。
将原始文档拆成 “前缀 — 中间 — 后缀” 后,DeepSeek-V3 使用 PSM(Prefix-Suffix-Middle)格式重新排列:
| <|fim_begin|> 前缀 <|fim_hole|> 后缀 <|fim_end|> 中间 <|eos_token|> |
FIM 仍采用自回归的下一 Token 预测目标,只改变文本排列顺序。
# 字节级 BPE
DeepSeek-V3 使用字节级 BPE(Byte-level Byte Pair Encoding),词表大小为 128K。其基本思路是将文本编码为字节序列,再通过反复合并高频相邻单元,学习常见的 Token;因此,一个 Token 可以对应字符的一部分、一个字符或多个字符。字节级表示能够覆盖不同语言和罕见字符。
新的预分词器支持将标点与换行符组合为一个 Token。但当提示以标点结尾、没有换行时,其分词边界可能与训练中的常见模式不同,引入 Token 边界偏差。为缓解这一问题,训练时会随机拆分一定比例的此类组合形式 Token,如拆分成标点和换行符两个,让模型适应不同的边界情况。
# YaRN 扩展
YaRN 通过按频段调整 RoPE 的旋转频率、调整注意力尺度,并配合额外训练,帮助模型适应超出原训练长度的上下文。
RoPE 在位置 m 对第 j 组二维分量施加旋转角度:
ϕm,j=mθj,
其中,θj 是该组的旋转频率。若统一将频率除以扩展倍数 s,虽然可以将更长的位置范围映射到原有角度范围,但也会缩小相邻 Token 的角度差,影响局部位置辨别。
YaRN 因此采用分频段调整:高频部分保留原频率,低频部分缩小频率,中间部分平滑过渡。其形式可概括为:
θj′=(1−γj)sθj+γjθj,
其中,高频部分 γj=1,低频部分 γj=0。这一设计兼顾局部位置分辨能力和长距离位置适应能力;此外,还通过调整 Softmax 前的注意力分数尺度,调节长序列中的注意力分布。
DeepSeek-V3 在预训练后进行两个扩展阶段,分别从 4K 长度扩展至 32K,再从 32K 扩展至 128K。
按论文描述,YaRN 应用于 MLA 的解耦共享位置 Key ktR。扩展后,模型可处理最高 128K 的上下文。
# PostTraining:后训练
DeepSeek-V3 的后训练主要包括监督微调(SFT)和强化学习(RL):先通过高质量示例学习指令遵循与回答方式,再利用奖励反馈提高回答质量,使模型更符合人类偏好。
# 数据构建
指令微调数据集包含约 150 万条样本,覆盖推理与非推理任务,不同领域采用不同的数据生成方式。
推理数据包括数学、编程竞赛题和逻辑谜题。先训练领域专家模型:
- 专家模型的 SFT:结合两类样本 ——
<问题, 原始回答> 和 <系统提示, 问题, R1回答> 。系统提示引导模型采用反思和验证等推理方式。 - 专家模型的 RL:通过高温度采样增加探索,使模型融合原始回答的简洁性与 R1 的推理模式,并逐渐在没有显式系统提示时也能使用这些模式。
- 生成与筛选:使用训练后的专家模型生成回答,再通过拒绝采样筛选高质量结果,作为最终模型的 SFT 数据。
拒绝采样可理解为 “生成候选,再依据质量标准保留合格回答”。
非推理数据包括创意写作、角色扮演和简单问答,由 DeepSeek-V2.5 生成回答,再由人工核验。
# SFT
SFT 使用 “指令 — 高质量回答” 训练模型,使其在给定指令和已有回答前缀时,提高正确回答 Token 的生成概率。
DeepSeek-V3-Base 在 SFT 数据集上训练 2 个 epoch。训练时将多个样本打包到一条序列中,并使用跨样本注意力掩码,使不同样本互不可见,同时保留各样本内部的因果约束。这与预训练阶段不屏蔽跨样本注意力的设置不同。
# Reward Model
奖励系统接收问题和模型回答,给出质量反馈,供强化学习使用。DeepSeek-V3 同时采用基于规则和基于模型的奖励。
基于规则的奖励通过确定的程序或规则验证回答,不需要另外训练一个神经网络来评分。例如数学和编程题。
基于模型的奖励利用训练好的评价模型判断回答质量。有参考答案时,可以判断语义是否正确;没有唯一答案时,可以评价是否切题、表达是否清晰、语气是否合适等。
DeepSeek-V3 的奖励模型从其 SFT 检查点初始化,再使用偏好数据训练学习评价标准;这些数据包含最终奖励以及形成该评价的思维链。
一种常见的偏好学习方式是:对于同一问题 q,标注回答 a+ 优于 a−,训练评分函数 rϕ:
LRM=−logσ(rϕ(q,a+)−rϕ(q,a−)).
# GRPO:组相对策略优化
GRPO(Group Relative Policy Optimization)对同一道题采样多个回答,比较组内奖励,提高优质回答的生成概率、降低较差回答的生成概率。它使用组内奖励估计基线,而不需要额外训练 critic 模型。
首先,区分三个策略模型:
| 模型 | 含义 | 更新方式 |
|---|
| πθ | 当前正在训练的策略 | 通过梯度更新 |
| πold | 生成当前这批回答的旧策略快照 | 本批更新期间固定,后续采样轮次刷新 |
| πref | 通常由 RL 开始前的 SFT 模型初始化的参考策略 | 通常在整个 RL 阶段固定 |
πold 用于衡量本次策略变化,πref 用于限制长期偏离。参考模型提供生成概率,不是负责质量评分的奖励模型。
对于问题 q,从旧策略采样 G 个回答 o1,…,oG,获得奖励 r1,…,rG,计算组内相对优势:
Ai=std(r1,…,rG)ri−mean(r1,…,rG).
高于组内平均奖励的回答具有正优势,低于平均的回答具有负优势。接着,定义当前策略与旧策略对同一回答的概率比值:
ρi(θ)=πold(oi∣q)πθ(oi∣q).
ρi>1 表示当前模型更容易生成该回答,ρi<1 表示更不容易生成。
GRPO 最大化以下目标:
JGRPO(θ)=E[G1i=1∑G(min[ρiAi,clip(ρi,1−ε,1+ε)Ai]−βDi)].
该目标包含两部分:
- 裁剪的策略收益:鼓励正优势回答、抑制负优势回答;通过 clip 限制继续扩大更新所带来的收益,避免一次更新过猛。它不是对概率比值施加硬性边界。
- KL 惩罚:限制当前策略偏离参考模型的程度,β 控制约束强度。
原文使用的逐样本 KL 估计项为:
Di=πθ(oi∣q)πref(oi∣q)−logπθ(oi∣q)πref(oi∣q)−1.
当两者对该回答给出的概率相同时,该项为 0;概率比偏离 1 时,该项为正。clip 约束相对旧策略的本次变化,KL 惩罚约束相对固定参考模型的累计偏离。
与标准 PPO 模型不同的是,PPO 通过学习一个价值模型 V 来估计优势,GRPO 则通过同一道题的多个回答之间的奖励比较来估计优势。